%20--%3e%3cdefs%3e%3cstyle%3e%20.st0%20{%20fill:%20%23a5d028;%20}%20.st1%20{%20fill:%20%23fff;%20}%20.st2%20{%20fill:%20%231de2db;%20}%20.st3%20{%20fill:%20%2341bdf9;%20}%20%3c/style%3e%3c/defs%3e%3cg%20id='logo-unaice-line'%3e%3cpath%20class='st1'%20d='M143.3,36.1c-1.2,0-2.1-.9-2.1-2.1V12.2c0-1.2.9-2.1,2.1-2.1s2.1.9,2.1,2.1v21.8c0,1.2-.9,2.1-2.1,2.1ZM143.2,6.2c-1.3,0-2.4-1-2.4-2.4v-.8c0-1.3,1-2.4,2.4-2.4s2.4,1.1,2.4,2.4v.8c0,1.3-1.1,2.4-2.4,2.4Z'/%3e%3cpath%20class='st3'%20d='M23.7,36.1H2c-.5,0-1-.4-1-1V2.3c0-.5.4-1,1-1h21.7c.5,0,1,.4,1,1v32.9c0,.5-.4,1-1,1'/%3e%3cpath%20class='st2'%20d='M41.8,36.1h-14.4c-.5,0-1-.4-1-1v-14.5c0-.5.4-1,1-1h14.4c.5,0,1,.4,1,1v14.5c0,.5-.4,1-1,1'/%3e%3cpath%20class='st0'%20d='M41.8,17.9h-14.4c-.5,0-1-.4-1-1V2.2c0-.5.4-1,1-1h14.4c.5,0,1,.4,1,1v14.7c0,.5-.4,1-1,1'/%3e%3c/g%3e%3cpath%20class='st1'%20d='M196.4,29.2c-2.1,2.1-3.6,3.2-7.1,3.2s-7.4-2.3-8.2-7.4h16.7c2.7,0,2.9-1.9,2.7-4-.7-6.2-5.3-11.2-11.6-11.2s-12.3,5.1-12.3,13.4,5.4,13.3,12.6,13.3,8.3-2.6,10-4.3c1.8-2.1-1.2-4.7-2.8-3ZM188.9,13.7c4.7,0,7.3,4.1,7.6,7.3h-15.3c.7-4.3,3.4-7.3,7.7-7.3Z'/%3e%3cpath%20class='st1'%20d='M132.1,12.9c-1.9-1.9-5.4-2.9-8.2-2.9s-5.3.5-8.2,1.8c-2.4,1-.9,5,1.6,3.7,2.1-1,3.3-1.5,6.3-1.5s6.7,1.1,6.8,6.1c-1.8-.5-2.7-.8-6.9-.8-6.8,0-11.3,3.3-11.3,8.8s4.1,8.4,10.1,8.4,5.4-.6,8.3-2.9v.5c0,2.8,4.2,2.6,4.2,0v-13.8c0-3.1-.8-5.5-2.7-7.4ZM130.4,26.2c0,3.6-3.4,6.3-8,6.3s-5.9-1.7-5.9-4.6,2.5-4.6,6.8-4.6c0,0,4.8,0,7.1,1v1.9Z'/%3e%3cpath%20class='st1'%20d='M80,36.1c-1.2,0-2.1-.9-2.1-2.1V3.4c0-1.2,1-2.2,2.2-2.2h.4c.8,0,1.4.4,2,1.1l20.2,25.7V3.4c0-1.2.9-2.1,2.1-2.1s2.1.9,2.1,2.1v30.7c0,1.1-.5,2-1.9,2s-1.9-.8-2.2-1.2l-20.7-26.2v25.3c0,1.2-.9,2.1-2.1,2.1Z'/%3e%3cpath%20class='st1'%20d='M60.2,36.5c-5.1,0-10.5-4.3-10.5-10.7v-13.5c0-1.2.9-2.1,2.1-2.1s2.1.9,2.1,2.1v13.1c0,4.5,2.5,7.1,6.6,7.1s7.3-3.2,7.3-7.5v-12.7c0-1.2.9-2.1,2.1-2.1s2.1.9,2.1,2.1v21.8c0,2.8-4.2,2.7-4.2,0v-.5c-1.5,1.6-3.3,2.9-7.6,2.9Z'/%3e%3cpath%20class='st1'%20d='M163.8,36.5c-7.1,0-13.1-6-13.1-13.3s4.8-13.5,13.5-13.5c4.4,0,6.9,2,8.8,3.7,1.8,1.5-.8,5.1-2.8,3.3-.8-.8-3.3-3-6.4-3-4.8,0-8.6,4-8.6,9.2s3.8,9.3,8.6,9.4c3.7,0,4.9-1,7-3.1,1.6-1.8,4.6,1,3,2.8-3,3-5.7,4.5-10,4.5h0Z'/%3e%3c/svg%3e)
ChatGPT hat Ende 2022 den Eindruck erweckt, als hätte die Maschine gerade erst das Schreiben gelernt. Tatsächlich wurden bereits in den Jahrzehnten zuvor große Mengen an Text durch NLG-Textroboter automatisch erzeugt. Nur funktionierte die Technik völlig anders. Heute haben Tools wie axite deren Aufgabe weitgehend übernommen.
Heute erscheint Textgenerierung verblüffend einfach. Wir geben einem Large Language Model einen Prompt, stellen ihm Informationen zur Verfügung und bitten es beispielsweise: „Schreibe daraus eine Produktbeschreibung.“
Doch auch vorher gab es schon Textroboter, die Tausende von Texten generieren konnten. Unseren Partner AX Semantics, das Unternehmen hinter dem Content-Generator axite, gibt es bereits seit mehr als einem Vierteljahrhundert.
Erst die Daten verstehen, dann schreiben
Wenn im Jahr 2021 ein Textroboter einen Produkttext, einen Fußballbericht oder eine Aktienanalyse veröffentlichte, dann stand dahinter meist eine Technik mit dem Namen Natural Language Generation (NLG).
Grundlage waren bei dieser Technik immer Daten, häufig zu einem Produkt. Aber auch im Journalismus kam die Technik zum Einsatz. Die Bundesagentur für Arbeit automatisierte so bereits 2005 einen Teil ihrer Arbeitsmarktberichterstattung, ebenso einige Newsportale.
Schreiben nach Regeln
Für die Vertextung der Daten braucht das System Regeln. Menschen definierten Satzstrukturen, Varianten, Synonyme und Bedingungen für deren Verwendung. Zufallselemente sorgten dafür, dass es auch für einen Anwendungsfall verschiedene Satzvarianten gab.
Vereinfacht gesagt konnte eine Regel beispielsweise lauten:
Wenn Produkt A besonders leicht ist, erwähne das Gewicht. Verwende dafür abhängig vom Kontext eine von mehreren geeigneten Formulierungen.
Aus sehr vielen solcher Regeln entstand ein System, das aus unterschiedlichen Datensätzen jeweils passende Texte zusammensetzen konnte. Je umfangreicher das Regelwerk und je besser die Datenmodellierung, desto vielfältiger und natürlicher konnten die Ergebnisse werden.
Das war wesentlich aufwendiger als ein heutiger Prompt. Der Vorteil war allerdings, dass nur Sätze entstehen konnten, die vorher festgelegt wurden. Auch moderne Systeme wie axite bieten daher noch immer die Möglichkeit, in Einzelfällen regelbasiert zu arbeiten. Doch wie gesagt ist das mit deutlich höherem Aufwand verbunden.
Am Beispiel eines Finanztextes
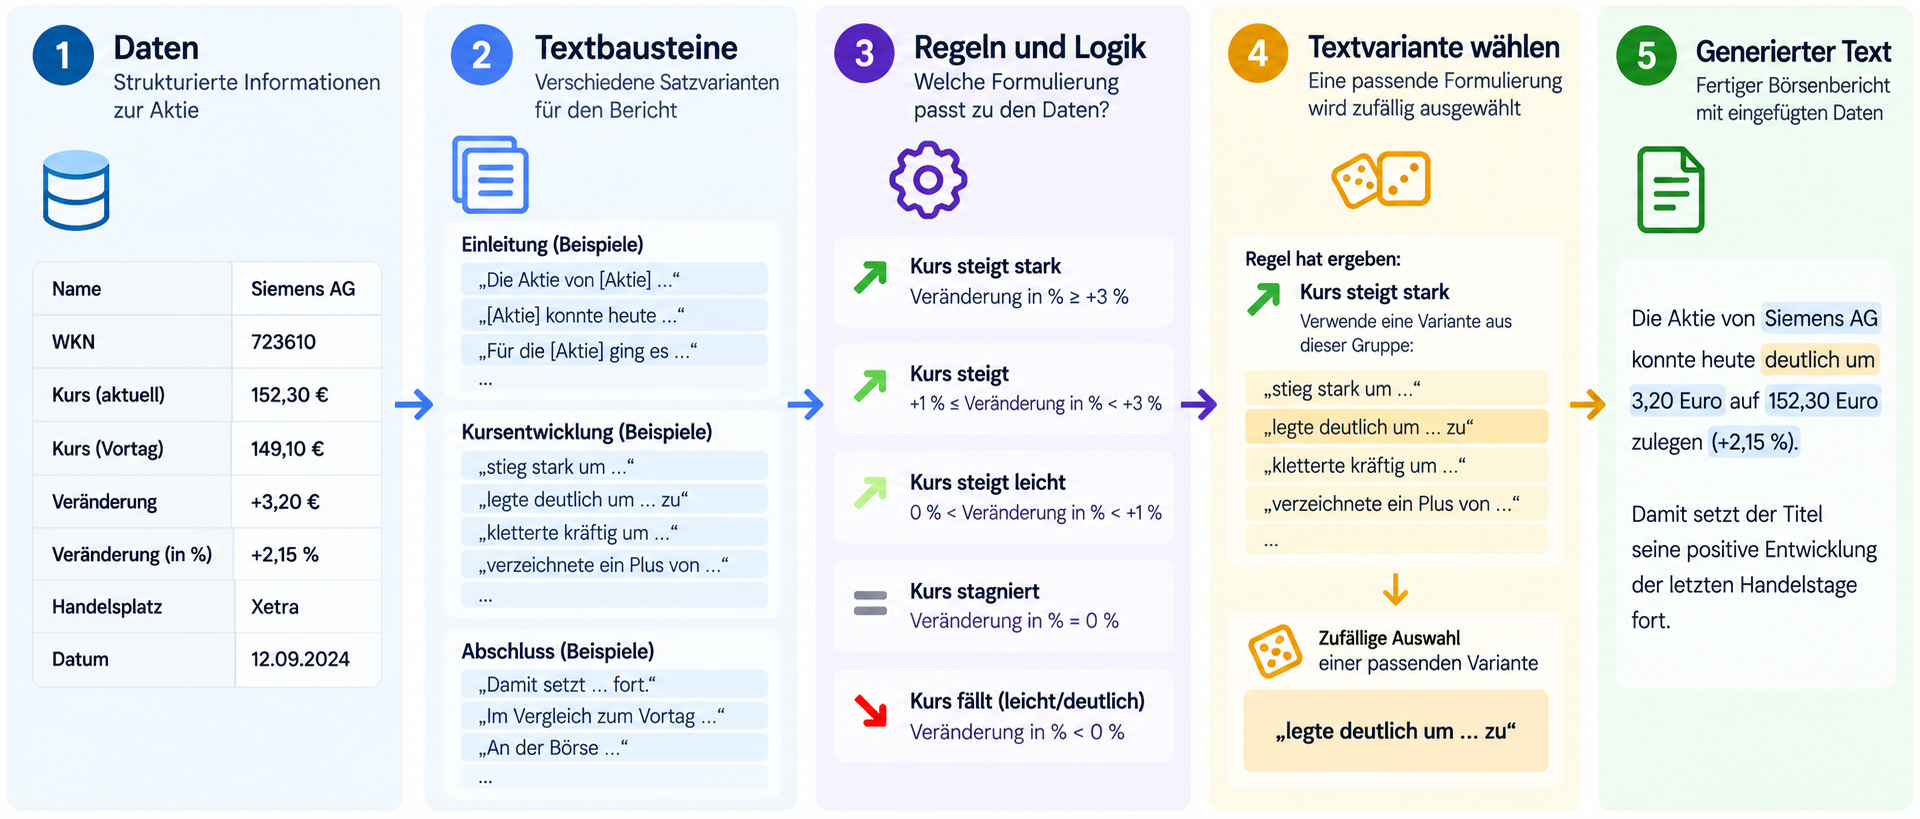
Auch wenn die Technik vor allem bei Produkttexten zum Einsatz kam, lässt sich das Verfahren besonders gut anhand eines Börsenberichts erklären.
Als Datenfelder stehen dann beispielsweise der Name einer Aktie, der Kurs, die Kursveränderung in Euro und die Veränderung in Prozent zur Verfügung.
Zunächst werden verschiedene Satzvarianten und Textbausteine erstellt. Diese werden dann mit Regeln verknüpft und durch die Daten ergänzt. In das Datenfeld [Aktie] wird beispielsweise der Name des Unternehmens eingesetzt, vielleicht auch noch die Wertpapierkennnummer. Dann wird je nach Kursentwicklung eine Formulierung ausgewählt, etwa „fiel deutlich“, „fiel“, „fiel leicht“, „stagnierte“, „stieg leicht“, „stieg“ oder „stieg stark“.
Bei stagnierenden Kursen folgt beispielsweise ein „bei“ und anschließend der Kurs. In allen anderen Fällen steht ein „um“, gefolgt von der Veränderung, und anschließend ein „auf“ mit dem neuen Kurs.
Damit sich die Sätze nicht zu sehr wiederholen, wurden außerdem verschiedene Satzvarianten geschrieben, von denen jeweils eine per Zufall ausgewählt wurde.
axite begann damit lange vor dem KI-Boom
Genau aus dieser Welt stammt axite. Die Geschichte des Unternehmens reicht bis 2001 zurück – mehr als zwei Jahrzehnte vor dem Start von ChatGPT.
Unter dem Namen AX Semantics spezialisierte sich das Unternehmen auf datenbasierte Textautomatisierung. Die zentrale Herausforderung bestand damals nicht darin, ein Sprachmodell mit einem möglichst guten Prompt zu versehen. Daten mussten modelliert, Zusammenhänge definiert und sprachliche Regeln aufgebaut werden.
Die Software hatte die Aufgabe, die Datenmodellierung und die Erstellung der Regeln so einfach wie möglich zu machen. Außerdem wurden im System Grammatik- und Rechtschreibregeln hinterlegt. So mussten nicht für jede Variante eigene Textbausteine geschrieben werden. Das System erkannte beispielsweise selbstständig, dass nach dem Wort „Hosen“ nicht „ist“, sondern „sind“ stehen muss, weil es sich um einen Plural handelt.
Über die Jahre entstanden auf diese Weise nach Unternehmensangaben mehr als 350 Millionen Texte für über 300 Kunden.
Warum dieses Wissen noch immer wertvoll ist
Mit modernen Large Language Models haben sich die technischen Möglichkeiten inzwischen grundlegend verändert. Viele Dinge, für die früher umfangreiche Regelwerke notwendig waren, können heute wesentlich flexibler gelöst werden.
Doch das über Jahrzehnte aufgebaute Wissen über Daten, Regeln, Qualität und automatisierte Content-Prozesse verliert dadurch nicht seinen Wert. Im Gegenteil: LLMs lösen zwar das Problem der flexiblen Sprachgenerierung – nicht automatisch aber die Frage, wie aus Unternehmensdaten zuverlässig guter Content entsteht.
Die Technik hat sich geändert, das Grundproblem nicht
Der Weg von der regelbasierten Textgenerierung zu heutigen Sprachmodellen ist deshalb mehr als eine interessante Geschichte aus der Frühzeit der KI.
Er zeigt, dass Textautomatisierung nie nur darin bestand, einer Maschine das Schreiben beizubringen. Die schwierigere Aufgabe war schon damals, ihr beizubringen, was sie auf Basis vorhandener Daten schreiben soll – und was nicht.
ChatGPT hat die Art verändert, wie Maschinen Sprache erzeugen. Die Herausforderung, Daten zuverlässig in guten Content zu verwandeln, ist geblieben.
Wollen Sie mehr über die Vorteile von axite erfahren? Dann vereinbaren Sie gleich mit uns einen Termin.